這款模型追求在現實世界中的實用性、更低成本、更強大功能,令其更具競爭力。
馬斯克也迫不及待地轉發了這個帖子,表示Grok 4.5 在至少幾個基準測試中排名第1,比預期好。
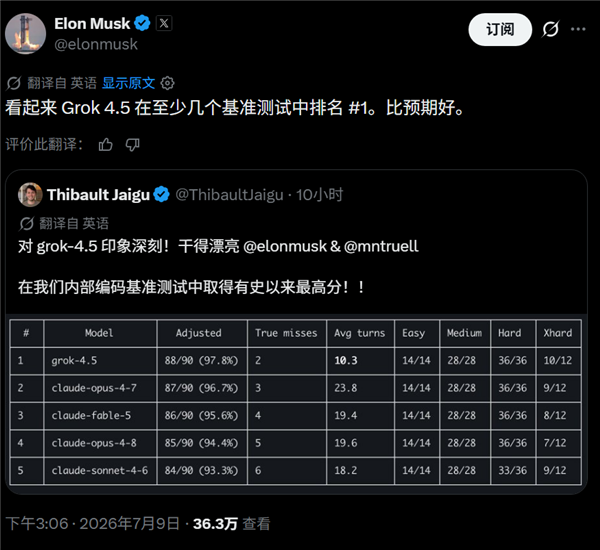
對於Grok 4.5來說,論性能應該還是超不過Fable 5這種等級的大模型的,馬斯克自己也承認,但他也提到了一個很有說服力的說法,那就是大部分任務也用不到Fable 5這樣的大模型。
事實也是如此,就算Fable 5性能最出眾,但它的定位和價格就注定了大部分開發者沒法暢快使用,除了個別任務需要用到Fable 5之外,大部分任務有Opus等級大模型的能力都是超預期了。
如果是看OpenRoutor的呼叫量,大眾需要的大模型,哪怕是開發者需要的程式碼能力也沒那麼高,DeepSeek V4 Flash這種用量才是最高的。
當然,大模型的頂級性能還是各大公司競爭的制高點,目前還是OpenAI和Anthropic領先一步,GoogleGemini 3.5 Pro不能爆發一波的話,御三家的位置要被馬斯克的Grok取代了。
中國這邊智譜GLM-5.2在AI程式設計上領先,但DeepSeek V4正式版預計會追上來,後面還有月之暗面的Kimi K3和稀宇科技的MiniMax M3 Pro,參數量和能力都會再上一個台階,追趕Opus等級的性能還是可以期待一下的。