SK 海力士希望把記憶體從 GPU 旁邊獨立出來,建立一個由多台 GPU、CPU 伺服器共同使用的大型記憶體池,藉此解決 AI 推論時 HBM 容量不足的問題
一、為什麼需要 Memory Pool?
目前 AI 伺服器的架構有幾個問題:- GPU 記憶體容量有限:HBM 必須緊貼 GPU,受到封裝空間限制。
- 記憶體資源無法共享:每張 GPU 都有自己的 HBM,容易出現某張 GPU 記憶體不足,另一張卻還有閒置容量的情況。
- KV Cache 不斷累積:多輪 AI 對話需要保留前面運算的中間資料,記憶體不足時就必須丟棄資料並重新計算。
- Agentic AI 加重負擔:多個 AI Agent 互相交換資料,對記憶體容量及資料傳輸的需求更高。
二、SK 海力士提出的新架構
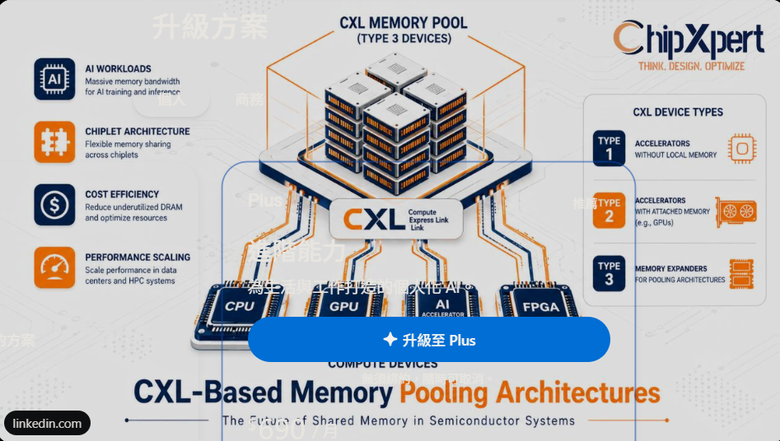
傳統架構:
- GPU + HBM 綁定。
- 每張 GPU 管理自己的記憶體。
- GPU 之間需要交換資料
- GPU Server Rack:負責 AI 運算。
- CPU Server Rack:負責 CPU 工作及系統管理。
- Memory Rack:獨立配置數十至數百 TB 記憶體。
- 各伺服器依照需求,共同存取 Memory Pool。
| 技術 |
用途 |
|---|---|
| CXL | 機櫃內連接及記憶體共享 |
| RDMA | 不同伺服器、機櫃之間高速傳輸資料 |
值得注意的是,這不是要完全取代 GPU 本身的 HBM,而是在原有 HBM 之外增加共享記憶體層。
三、實驗數據:首次 Token 生成時間
這是報導中最值得注意的數據。SK 海力士與合作夥伴進行多輪 AI 推論測試:
Time to First Token(TTFT)
首次生成 Token 所需時間,越低越好
傳統重新計算 80.76 秒
遠端 SSD Cache 33.56 秒
遠端 CXL DRAM 15.45 秒
約 5.2 倍改善
CXL DRAM 相較於傳統重新計算,首次 Token 等待時間縮短約 80.9%。
這代表當 KV Cache 可以保存在遠端 CXL DRAM,而不必丟棄後重新計算,推論效率能大幅改善。
四、為什麼 SK 海力士選擇與 Intel 合作?
SK 海力士副總裁 Joo Young-pyo 特別提到 Intel,主要原因包括:- Intel 在 CPU 及伺服器運算領域具有技術優勢。
- Agentic AI 時代,CPU 在多個 Agent 之間的協調及資料管理扮演更重要角色。
- Intel 正積極推動 CXL 生態系統。
- 記憶體池需要 CPU、記憶體控制器、連接介面及軟體共同配合。
雙方不只是採購或供應關係,而是從系統設計階段就開始合作。
五、目前仍然存在的技術問題
這個架構還不是可以直接大規模商用的成熟產品,主要挑戰包括:- CXL 記憶體共享的延遲能否符合大型 AI 伺服器需求。
- 大規模跨機櫃連接時的穩定性及可靠性。
- 作業系統、驅動程式、AI Framework 如何管理共享記憶體。
- GPU 如何有效率地存取遠端 KV Cache。
- 如何避免大量 GPU 同時存取 Memory Pool 時產生頻寬競爭。
六、我的技術觀察:這可能改變 HBM、DDR5 與 CXL 的市場定位
這個方向值得關注,因為它可能形成新的 AI 記憶體階層。未來 AI 記憶體階層
L1:GPU HBM
最高頻寬、最低延遲,放置最重要的即時運算資料
L2:CXL Memory Pool
大容量共享 DRAM,保存 KV Cache 及其他中間資料
L3:NVMe SSD
更大容量,保存冷資料及較少使用的 Cache
| 記憶體 |
主要角色 |
特性 |
|---|---|---|
| HBM | GPU 即時運算 | 高頻寬、高成本 |
| DDR5 | CPU 主記憶體 | 容量較大、成本較低 |
| CXL DRAM | 共享記憶體池 | 跨伺服器共享 |
| NVMe SSD | 大容量儲存 | 容量大,但延遲較高 |
我認為有三個值得注意的產業影響:
- 對 SK 海力士:不再只是銷售 HBM、DDR5 等記憶體晶片,而是開始參與 AI 伺服器的記憶體架構設計。
- 對 Intel:CXL 有機會成為 Intel 在 AI 伺服器市場的重要戰略位置,即使 GPU 運算市場由 NVIDIA 主導。
不過,必須注意:CXL DRAM 並不能取代 HBM。兩者的頻寬、延遲及使用方式仍有明顯差距。
最重要的結論:這項技術的真正價值,不是讓遠端 DRAM 變得跟 HBM 一樣快,而是讓 AI 系統不必把所有資料都塞進昂貴且有限的 GPU HBM,從而提高整體記憶體使用效率。