old_hsiao wrote:假如這是真的,高貴Ai...(恕刪) DeepSeek 的新論文比較有看頭…https://srtechmedia.com/news/fff6de6e-fe7a-4508-b2cf-602d65b60f7b-----------當地時間 2 月 18 日,DeepSeek 官方發文公布了一篇新的論文,值得關注的是,論文中提出了一種新的注意力機制「NSA」。據 DeepSeek 介紹,「NSA」是一個用於超快長上下文訓練和推斷的本地可訓練的稀疏注意力機制,並且還具有與硬體對齊的特點。-----------提出新算法NSA, 等於在超長上下文中畫重點,然後分重點研究,而且思考過程直接對齊硬體。一直以來 DeepSeek都是跳過CUDA的。超長上下文一直以來就是算力瓶頸,所以新算法針對超長上下文處理降低算力需求。其實人腦在運作時耗能很低,所以老美堆算力不見得就是對的路,到一個臨界值AI就上不去了。
old_hsiao wrote:假如這是真的,高貴Ai...(恕刪) 去年初我就說訓練不需要CUDA,還有人跟我辯…現在所有前沿的研究都會跳過 CUDA,直接用組語調動硬體做算法想做的事情。用更基本的算子調動硬體,也有有助與跨硬體平台的移植。現在DeepSeek訓練已經是跨硬體平台驗證,然後出論文。如果其他各團隊繼續依賴CUDA,只會被越甩越遠。

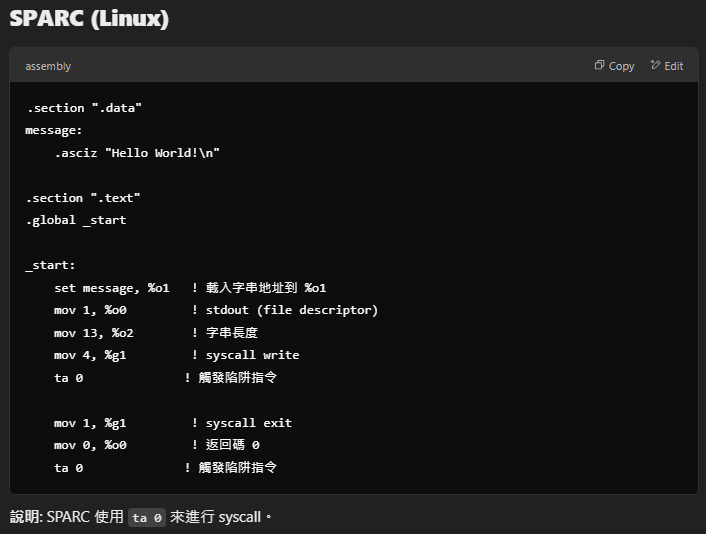
smallbeetw wrote:去年初我就說訓練不需要CUDA,還有人跟我辯…現在所有前沿的研究都會跳過 CUDA,直接用組語調動硬體做算法想做的事情。用更基本的算子調動硬體,也有有助與跨硬體平台的移植。現在DeepSeek訓練已經是跨硬體平台驗證,然後出論文。如果其他各團隊繼續依賴CUDA,只會被越甩越遠。 您說的「組語」,沒猜錯的話是組合語言?以目前PC主機板的BIOS程式,十年前吧(或是更早)都已經在用C++撰寫寫程式強調「可讀性」最重要,也是N年前在提倡的你現在提組合語言?當年為什麼沒有CUDA,那些人搞不出什麼了不起的成果?為什麼有了、用了CUDA突然大進步,您知道CUDA是什麼嗎?我想您一定知道,但您認為組合語言才是王道開心最重要,您說的都對沒有CUDA這樣的工具,你要「調動硬體做算法想做的事情」 ?別家晶片也都很強悍(如AMD),但他為什麼比不上NV因為沒有CUDA,寫程式算AI哪有這麼簡單?組合語言這麼多人用?這麼好學?可以用組合語言來做運算?尤其是高深的數學運算?你試試看,用組合語言寫點數學公式跑跑看?開心最重要,您說的都對
號稱「地球上最聰明的人工智能」,馬斯克的 Grok 3 竟答不對 9.11 和 9.9 哪個大02月19日 12:07昨天馬斯克及其 xAI 團隊在直播中正式發佈了 Grok 3,此前馬斯克通過持續的預熱宣傳,將外界對 Grok3 的期待值推向了前所未有的高度。馬斯克稱 Grok 3 為,然而其實際表現似乎對不起這個名號。在發佈會上,馬斯克宣稱 Grok 3 在數學、科學與編程的基準測試中超越了所有主流模型,並計劃將其應用於 SpaceX 的火星任務計算,甚至預測未來三年內將實現盧保獎級別的突破。但 Grok 3 的實際測試表現卻讓人大跌眼鏡。發佈後,一些媒體測試了最新的 Beta 版 Grok 3,並提出了那個經典的用來刁難大模型的問題:「9.11 與 9.9 哪個大?」遺憾的是,號稱目前最聰明的 Grok 3,仍然無法正確回答這個問題,被網民戲稱為「天才不願意回答簡單問題」。此外,在 xAI 發佈會直播中,在分析遊戲《流放之路 2》的職業與昇華效果時,Grok 3 也給出了大量錯誤答案,並且馬斯克也沒有看出這些明顯的錯誤。儘管在官方 PPT 中,Grok3 在大模型競技場 Chatbot Arena 中看似「遙遙領先」,但實際上其與 DeepSeek R1 和 GPT4.0 的差距僅為 1% 到 2%。
smallbeetw wrote:現在所有前沿的研究都會跳過 CUDA,直接用組語調動硬體做算法想做的事情。用更基本的算子調動硬體,也有有助與跨硬體平台的移植。現在DeepSeek訓練已經是跨硬體平台驗證,然後出論文。如果其他各團隊繼續依賴CUDA,只會被越甩越遠。 請問大哥 你怎麼得到那樣的結論? 還是在腦補?看看下面的assembly code. 有一樣嗎?======請先看看這個講 the moat of Nvidia software stack 再講你自己的看法吧===Deepseek 動PTX的原因 在這個