NVIDIA RTX Spark 讓 AI 新手也能在筆電上快速架設 AI 代理並且開始使用。
在看過了 RTX Spark 系統的整體概述(請見:【Part1】要價超過 18 萬的筆電能玩什麼?NVIDIA RTX Spark Editors Day 美國舊金山現場揭密)、遊戲效能表現(請見:【Part2】要價超過 18 萬的筆電能玩遊戲嗎? NVIDIA RTX Spark 遊戲效能實機測試)之後,接著這篇來看這次 RTX Spark 可說是最重要的部分:AI 代理應用,從 NVIDIA 在概述的簡報中就可以看出,RTX Spark 就是為了在日常低功耗的使用環境下,提供大容量記憶體配置來運作 AI 的產物,加上相對專業 GPU 便宜的售價,可說是為了想要進入地端 AI 領域的使用者,另一個提供完整 CUDA 環境的選擇,加上這次 NVIDIA 跟微軟聯手在 Windows 作業系統內打造的輕鬆設定/安全環境,可說是相當適合對作為於 AI 有興趣(且多金)的地端 AI 新手入門選擇。
更多 RTX Spark 體驗與介紹:
【Part1】要價超過 18 萬的筆電能玩什麼?NVIDIA RTX Spark Editors Day 美國舊金山現場揭密
【Part2】要價超過 18 萬的筆電能玩遊戲嗎? NVIDIA RTX Spark 遊戲效能實機測試
核心效能測試:
NVIDIA RTX Spark 輕薄筆電測試報告|AI 生成、內容創作與遊戲效能真能一機搞定?!
另外陳拔也拍了一段 RTX Spark 的體驗心得影片,如果不想看圖文的人可以看看這邊:
NVIDIA 官方簡報介紹
同樣的先來看 NVIDIA 的官方對於 RTX Spark 在 AI 代理的應用,這部分是由地端 AI 與遊戲部門的副總裁 Jason Paul 來介紹。
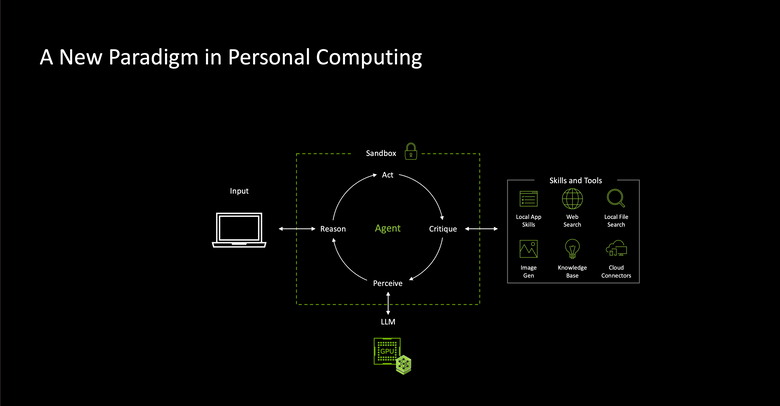
首先 Jason Paul 就表示,新世代的個人電腦已經走向一個新的階段,使用者輸入之後進行處理的不再是軟體,而是在一個封閉沙盒中運作的 AI 代理,在認知、理解、批判、動作的循環中,了解使用者輸入的意圖,呼叫 Skill 或工具,搭配 LLM 在 GPU 內運算出使用者期待的結果並且執行。
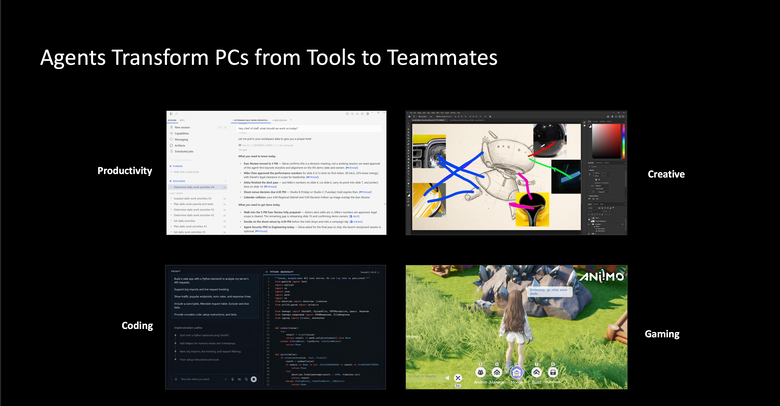
而這樣的新 PC 工作流,也讓 PC 的角色由過去的單純被動使用工具,成為主動協助使用的隊友角色,不管是在一般生產力作業、內容創作、程式撰寫或是遊戲部分,AI 都帶來了相當革命性的轉變。
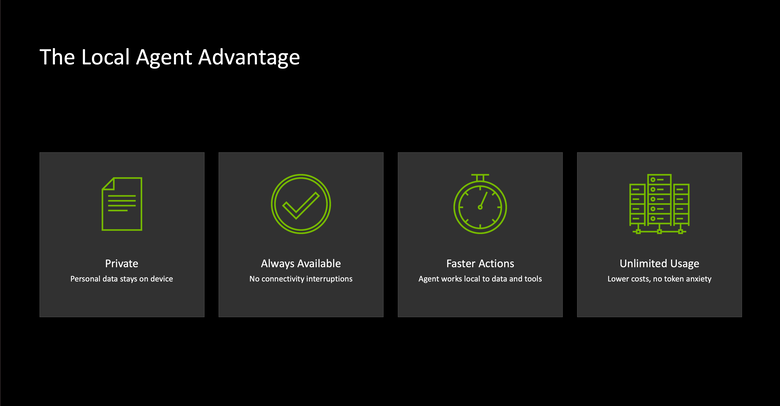
而在雲端 AI 跟地端 AI 的選擇上,地端 AI 具備了隱私保護、隨時可用、可以快速反應以及幾乎無限制的使用量等優勢。
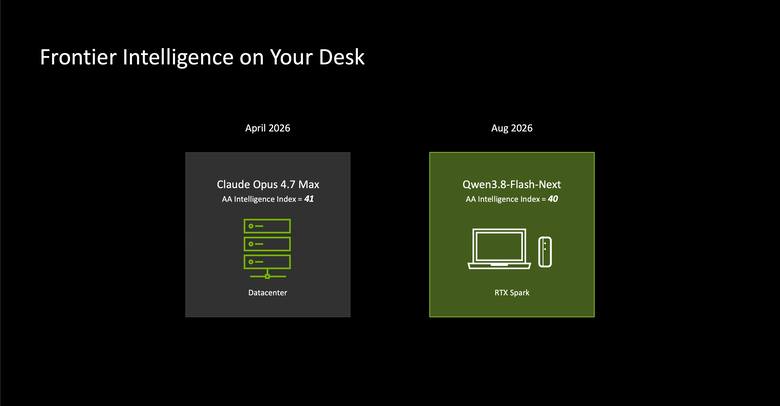
而過往雲端 AI 最大的效能優勢部分,現在在地端 AI 也有了接近前沿 AI 效能表現,幾乎已經僅有 6 個月左右的差距。
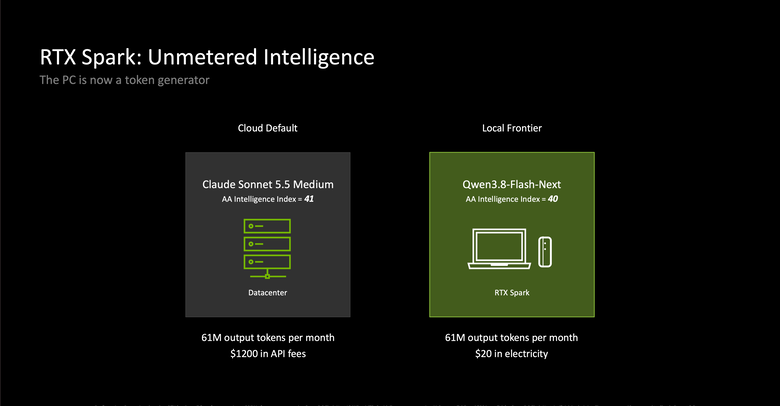
以可以在 RTX Spark 上運作的 Qwen 3.8 Flash-Next 開源模型來說好了,效能已經可以跟 Claude Opus 4.7 Max 以及 Claude Sonnet 5.5 Medium 這類的雲端前沿 AI 模型看齊了,而且在花費更少,以同樣每月輸出 6100 萬的 Token 的數量來說好了,雲端前沿 AI 模型需要 1200 元美金的課金成本,但是在地端模型就只需要差不多 20 美元的額外電費。
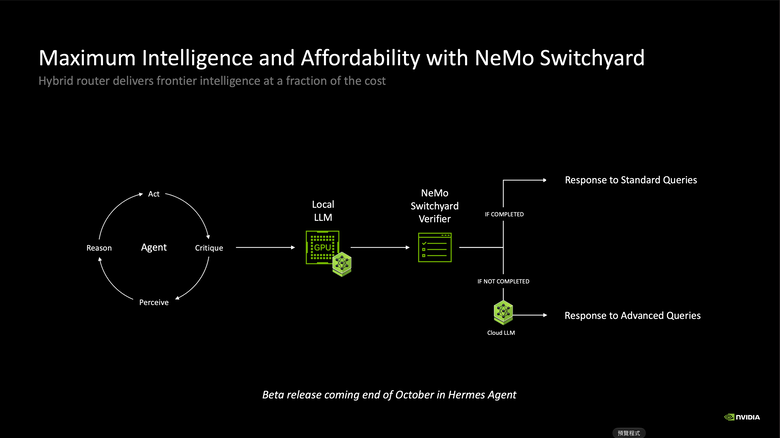
不過地端 AI 有價格優勢,雲端前沿 AI 有效能優勢(時不時還會降價或是回復額度),如果只選擇一邊用真的很吃虧,所以這次 NVIDIA 還推出了一個混合雲端的概念,透過 Nemo Switchyard 的混合路由設計,結合了地端 AI 的成本優勢以及雲端 AI 的效能優勢,在 AI 代理搭配本地 LLM 模型進行分析後,交由 NeMo Switchyard 來判斷工作需使用地端還是雲端 AI 運算,在可負擔的成本範圍內提供最大化的智慧運算效能。
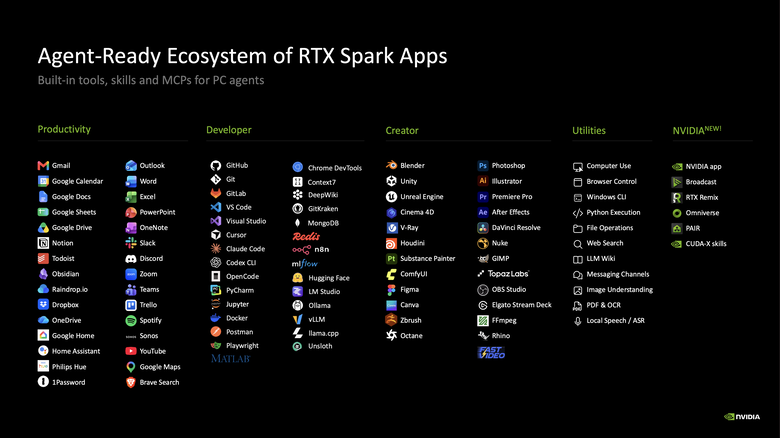
而可以透過 AI 代理驅動的應用程式現在已經很多了,不管是日常工作、程式開發、內容創作,系統工具或是 NVIDIA 本身所推出的各項應用,現在都內建了工具、Skill 或是 MCP(Model Context Protocol,模型上下文協定 )可以串連 AI 代理,透過簡單的問答,就能執行複雜的電腦操作或是應用,提供使用者更有效率的工作/生活型態。
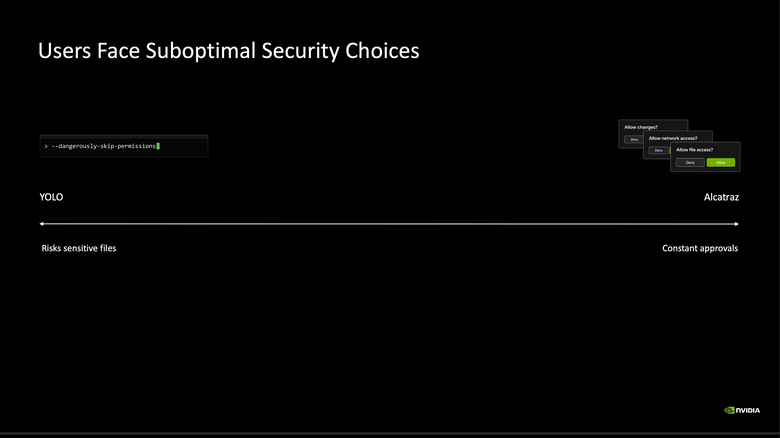
不過使用 AI 代理的人,常常面臨到的問題就是安全性的選擇,想要方便,高度自動化執行的 AI 代理,就要可能承受 AI 代理可能搞亂資料或是系統的風險,而具備安全性的設計,在運作過程中就會持續被打斷詢問使用者同意問題,反而讓使用者一直被 AI 代理綁住,所以在這部分的軟體設計就要在這兩者間作平衡。
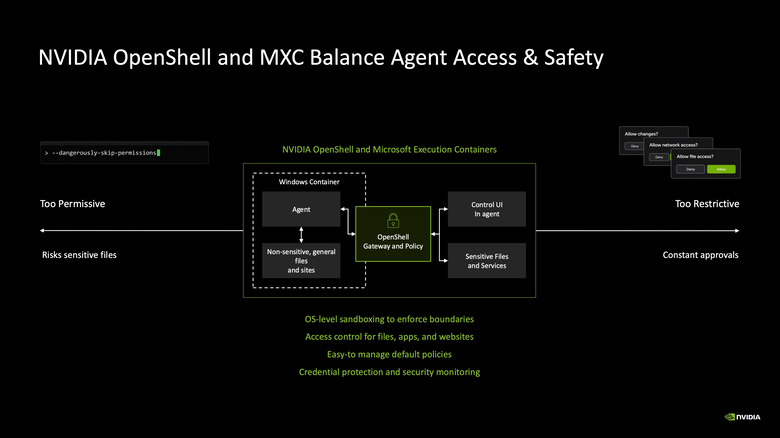
所以針對這部分,NVIDIA 跟微軟這次推出了平衡了這兩點的安全設計,將 OpenShell 跟微軟執行容器(MXC)整合在一起,將 AI 代理關在受到 OS 等級的隔離容器內執行,AI 代理可以控制檔案、App 跟網頁,使用者也可以輕鬆管理並且對 AI 代理建立規範,這個容器也提供了受信賴的保護以及安全監控功能。
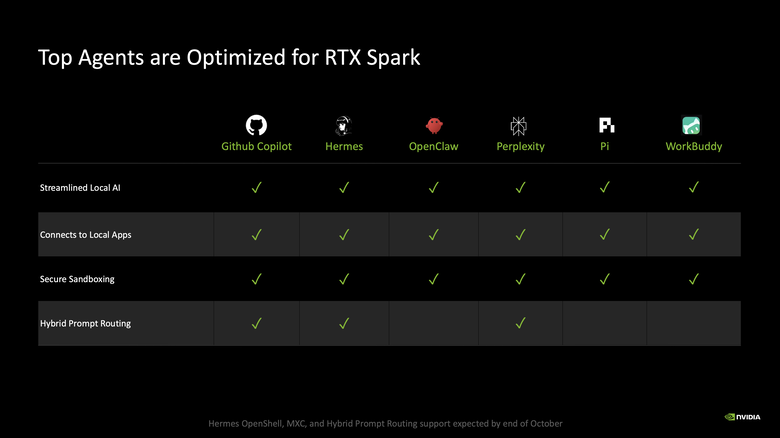
而在實用層面上,這次 RTX Spark 也針對目前最多人使用的幾款 AI 代理直接進行最佳化設定,包括微軟的 Github Copilot、Hermes、OpenClaw、Perplexity、Pi 跟騰訊的 WorkBuddy,在簡報中還列出了已經針對 RTX Spark 最佳化的內容。
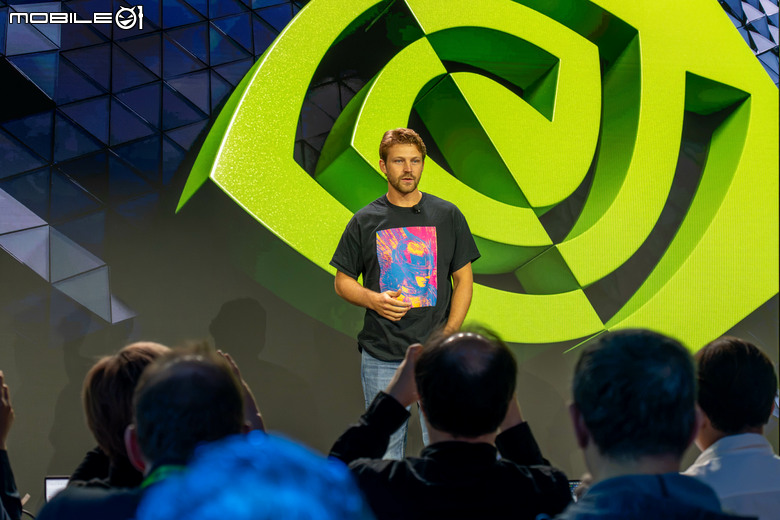
其實在這次 NVIDIA 的 RTX Spark Editors Day 活動中,還請來 Hermes 的 CEO Dillon Rolnick 上台示範 Hermes 的使用情境(話說國外新創的 CEO 怎麼都這麼年輕)。
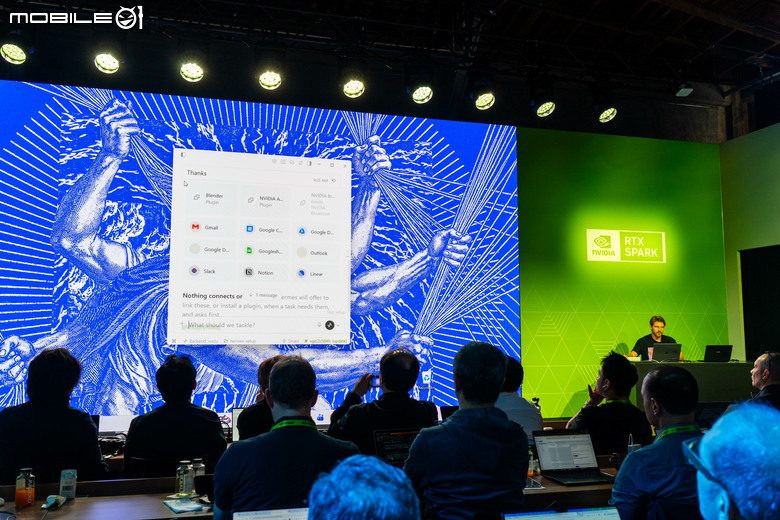
現場直接展示了 Hermes 跟其他應用 API 串接後的使用情境。
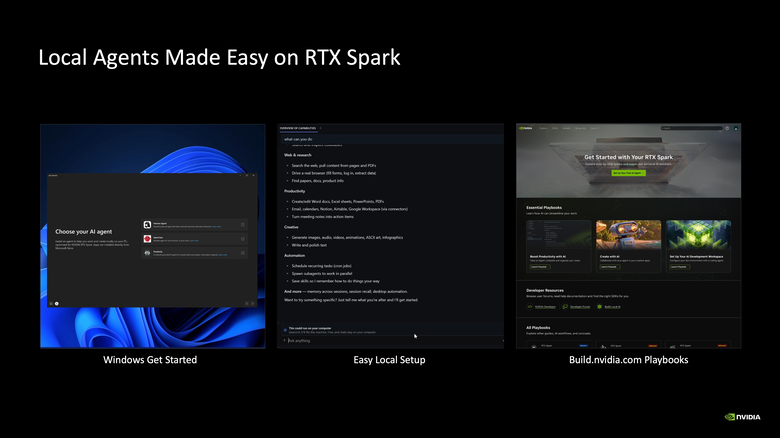
回到簡報內容,而這次 NVIDIA 跟微軟合作,在『更方便使用 AI 代理』這件事情上,在 RTX Spark 上面推出很多更新設計,像是新的 Get Start 啟動畫面、更方便的地端設定、以及在 Build.nvidia.com 上面提供各種應用的 Playbook 使用手冊等等,其中前兩者真的是大大降低了地端 AI 代理的設定門檻,這個部份等下陳拔也會利用實機展示給大家看。
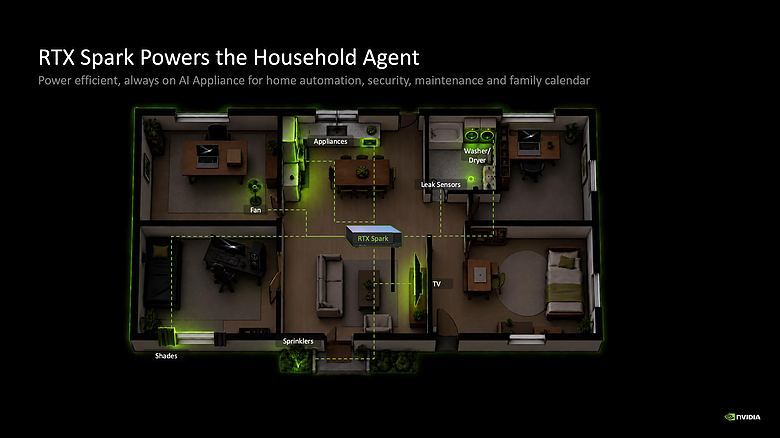
除了本機端的使用外,這次 NVIDIA 也讓 RTX Spark 扮演了家中的核心 AI 代理控制角色,透過 AI 代理跟家中其他物聯網裝置的連接,可以讓 RTX Spark 裡的 AI 代理控制家中的各個智慧家電,使用者在外只要透過跟 AI 代理互動的介面(像是 LINE 這樣的即時通訊軟體就可以),就能控制家中的各個電器或設備,當然你要讓 AI 代理自動控制也可以。
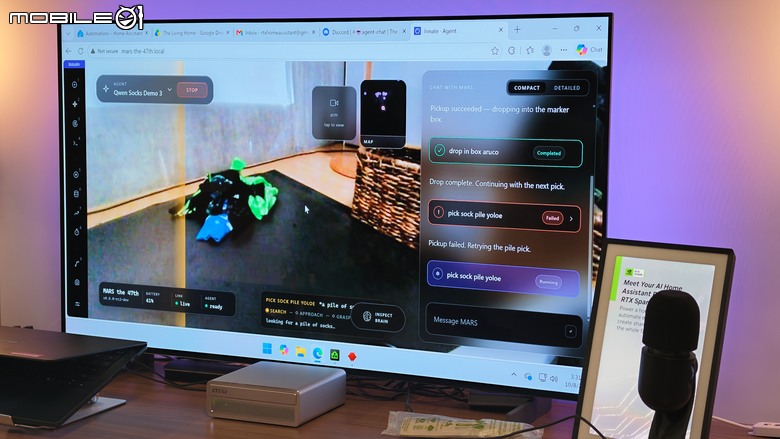
其實在 RTX Spark Editors Day 活動現場就有這樣的展示,利用 RTX Spark 上的 AI 代理來控制同一個區域網路內的物聯網裝置。(展示的情境是直接控制一台機器人....)
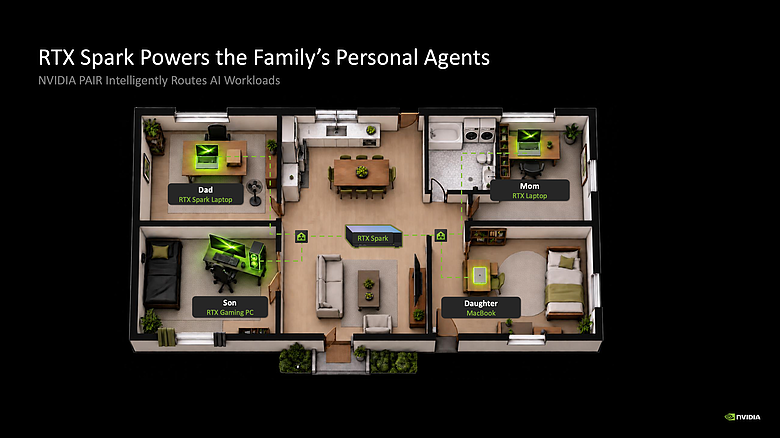
另外早先 NVIDIA 推出的 PAIR 互連概念,在這次的 RTX Spark 發表時也更加落實,可以讓 RTX Spark 扮演成家中 AI 控制中心的角色,透過 NVIDIA PAIR 互連軟體,可以控制家中不同的 RTX 電腦(不管是桌機或是筆電)或是支援的裝置(圖裡面有蘋果的 MacBook), 將不同的模型分配給適合算力的機器使用,讓家裡裝置的 AI 算力不浪費?
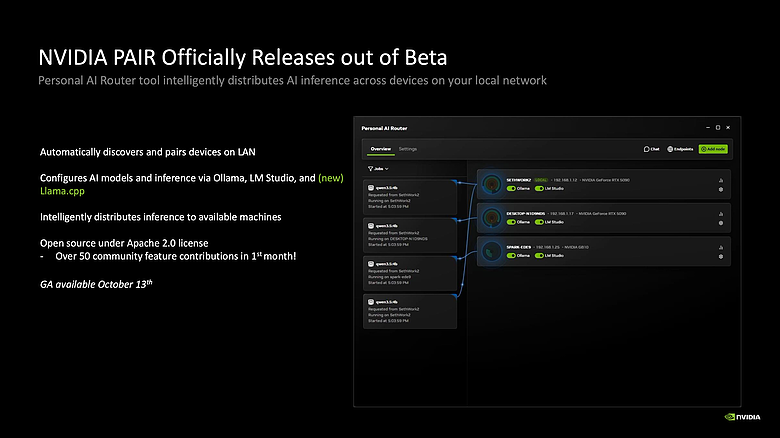
而在這次 RTX Spark 發表時,NVIDIA PAIR 也正式推出了 Beta 的試用版本,可以自動偵測區域網路內可以連接配對的裝置,支援包括 Ollama、LM Studio 以及 llama.cpp 等推論架構設定。
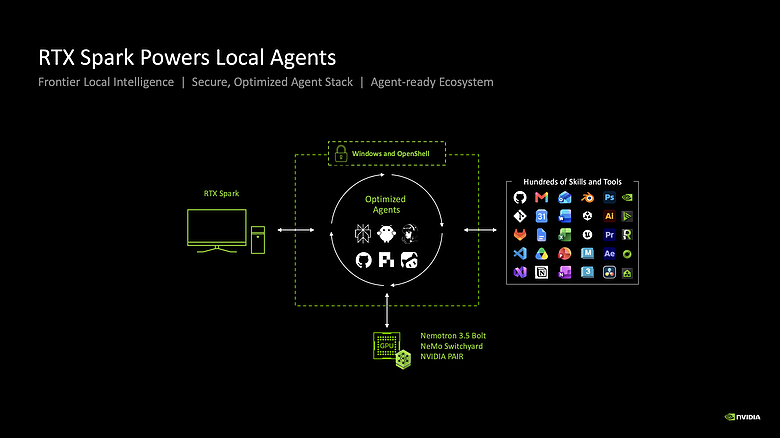
而在簡報的最後,NVIDIA 再度強調透過 RTX Spark 以及最佳化 AI 代理的結合,讓電腦進入了地端 AI 代理的時代,提供了接近前沿模型的 AI 算力、並且具備安全性、以及對 AI 代理最佳化的軟體設定以及生態系。
NVIDIA RTX Spark AI 代理實戰
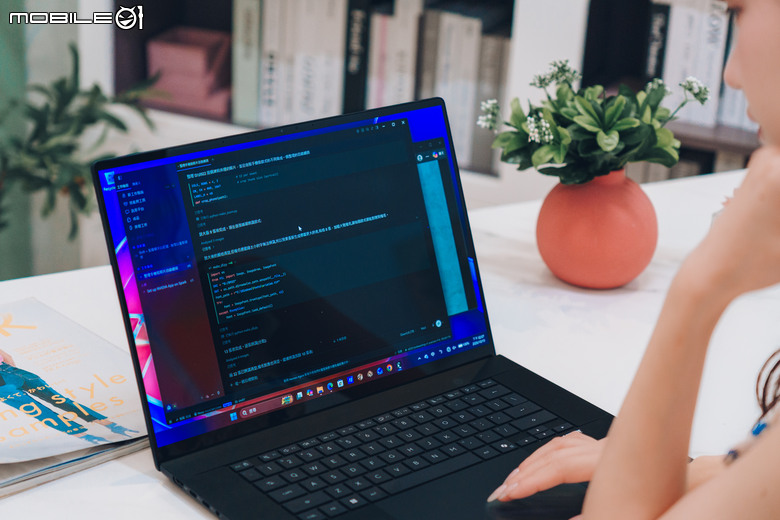
在 NVIDIA RTX Spark 上面運作本機端的 AI 代理。
看完了紙上談兵的簡報內容後,既然有實際的 RTX Spark 裝置在手,當然要來試試看怎麼操作啦,首先就從設定開始吧,先前不管是在微軟的發表活動(請見:)或是 NVIDIA RTX Spark Editors Day 活動中的簡報,都很強調這次 RTX Spark 搭載新版 Windows 作業系統,在 AI 代理設定上的便利程度,所以就從這個部分開始。
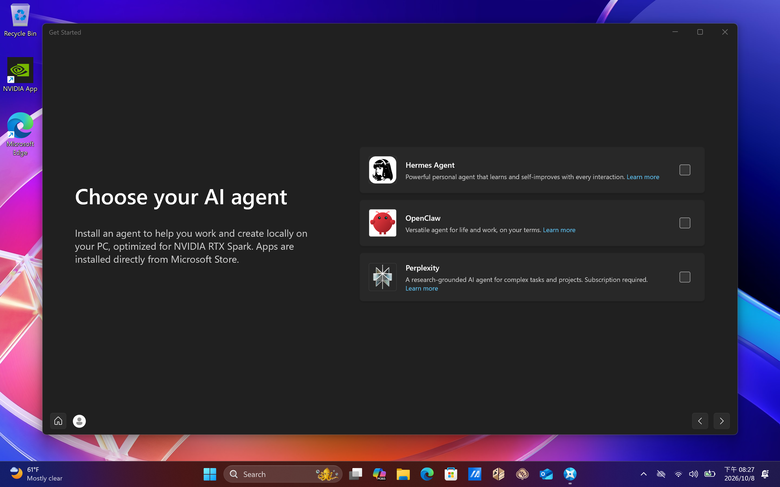
在一開始啟動 Windows 的 Get Start 畫面中,新版的 Windows 就會直接問你是不是要安裝 AI 代理,可以讓使用者在 Hermes、OpenClaw 以及 Perplexity 三個 AI 代理中選擇。
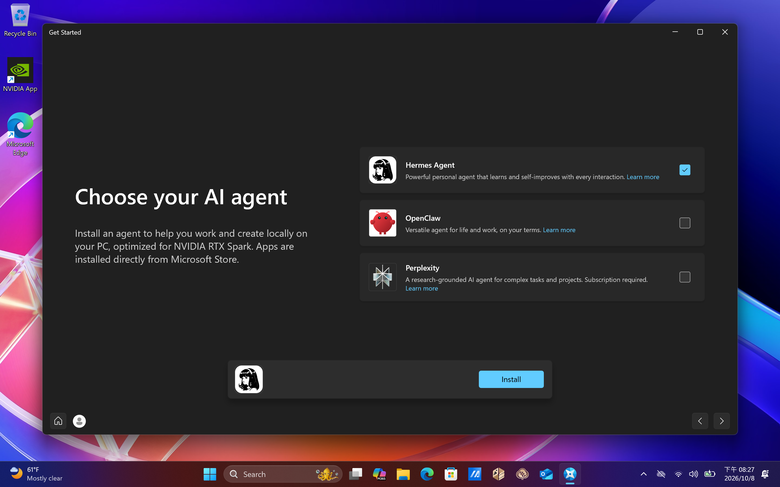
確認後就會自動開始下載並且設定,陳拔在這邊選擇的是上面功能列表中比較完整的 Hermes 來體驗,不過微軟的 Peter Dawoud 在 NVIDIA RTX Spark Editors Day 活動中也表示,未來會有更多 AI 代理整合到這個介面中讓使用者選擇。
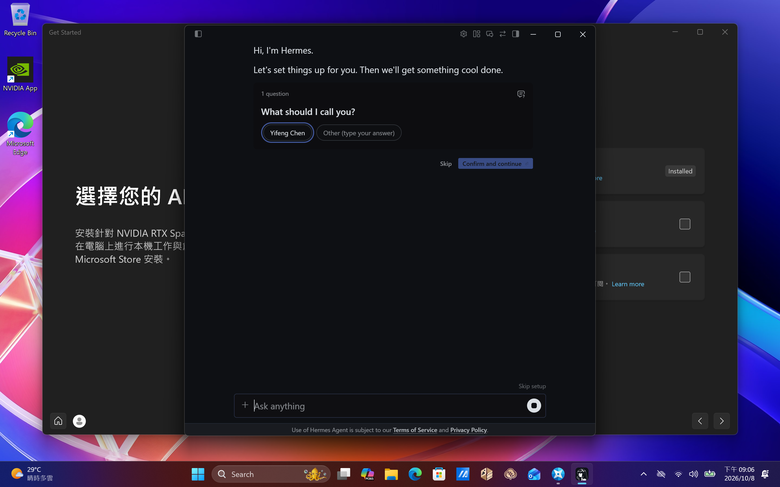
安裝完成之後就會開始問你一些問題,像是要怎麼稱呼你啊?
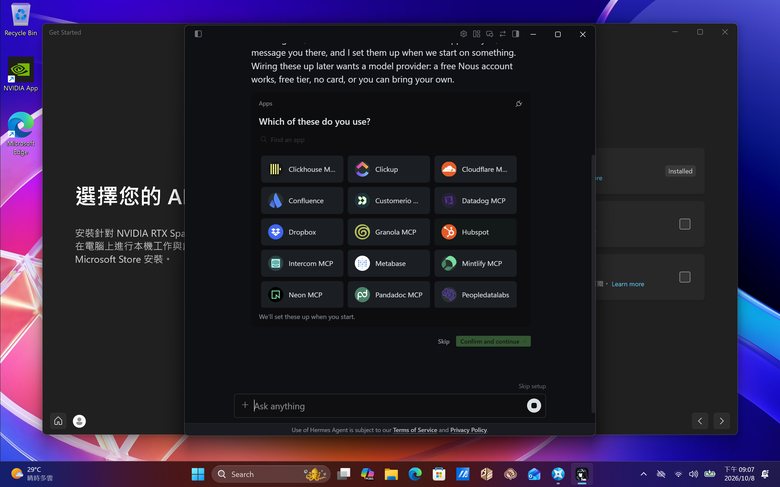
或是你要裝什麼 MCP(模型上下文協定)等等,就連本地端的執行環境(這邊是用 llama.cpp)都會一併安裝好。下載安裝完成後,就可以進入到 Hermes 的介面,畢竟要嘗試完全透過 RTX Spark 的地端 AI 效能來運作,所以在這邊還要先設定一下要下載哪個地端開源模型來用。
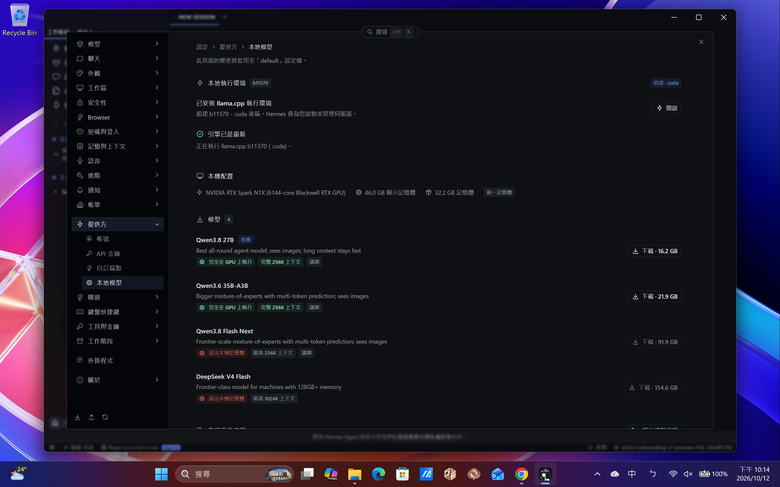
(點擊可看大圖)在 Hermes 的設定介面中,可以在『提供方』這個項目中選擇想要安裝使用的地端模型,預設提供了 Qwen 3.8 27B、Qwen 3.6 35B-A3B、Qwen 3.8 Flash Next 或是 DeepSeek V4 Flash 這四個模型,但是在 64 GB 版本的 RTX Spark 上,就僅能安裝前兩者,要 128GB 記憶體容量的版本,才能安裝後兩者參數量比較大的模型。
在設定完成之後,就可以在 RTX Spark 上面,透過完全的地端模型來執行 AI 代理了,這個時候使用者就可以直接在 AI 代理的聊天室窗中,開啟新工作階段來請 AI 代理來幫你做事,當然也可設定排程工作進行自動化作業,等到用得熟了一點,還可以自行編寫 Skill 或是工具,讓 AI 代理變得更個人化,而這些資料完全都是儲存在自己的電腦上,對隱私也有相當大的保障,這就是地端 AI 的優勢了。
首先先來看 RTX Spark 在 AI 效能測試軟體上的表現,陳拔利用了 MLPerf 以及 UL Procyon 內的 AI 文字生成測試這兩個項目來進行測試,以下是測試結果:
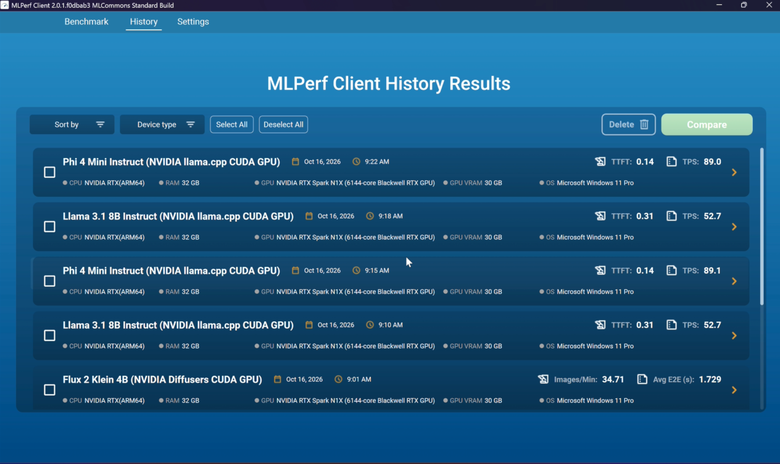
RTX Spark 在 MLPerf 中的測試表現,這一頁主要是針對 LLM 進行測試的結果,可以看到在對 Phi 4 Mini 跟 Llama 3.1 8B 這兩個模型的測試中,RTX Spark 的 TTFT 首個 Token 產出時間都大約在 0.14 秒到 0.31 秒左右,而平均每秒產生的 Token 數量大概是 89 跟 52.7。
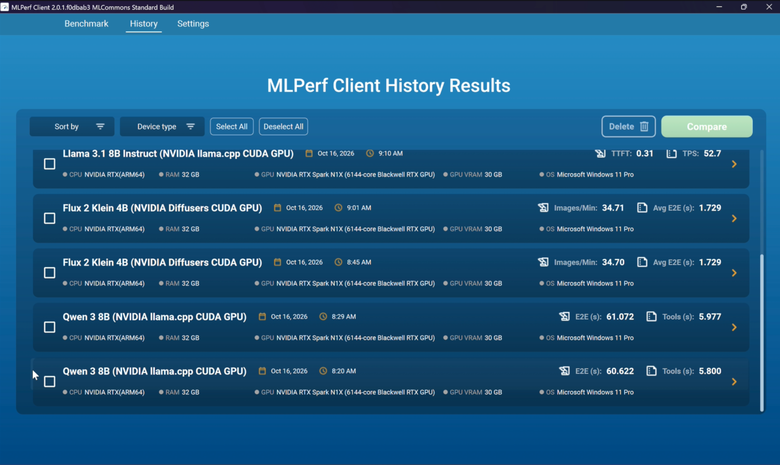
而在影像生成的 Flux 2 Klein 4B 模型的測試中,RTX Spark 獲得了每分鐘可生成 34.7 張 1920 x 1080 解析度影像的效能表現。最下方的 AI 代理測試中,利用 Qwen 3 8B 模型的測試項目中,完成一項測試作業的時間大約需要 60 秒左右,呼叫 CPU 工具的時間大約是 5.9 秒。
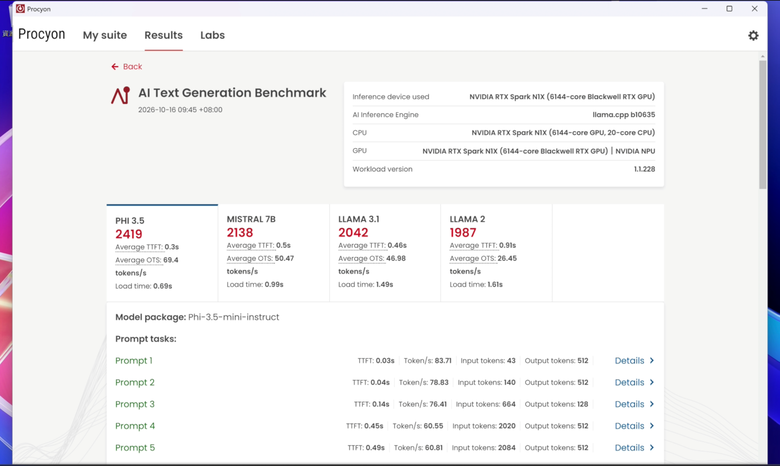 RTX Spark 在 UL Procyon 的 AI 文字生成效能測試部分成績表現,基本上就是 5070 的等級表現,所以 RTX Spark 的最大價值還是在那個統一記憶體的設定上。
接著就來看 RTX Spark 在執行地端 AI 代理的實際表現吧,就如前面所說的,畢竟陳拔這次借到的是 64 GB 記憶體的版本,所以就不能使用如 Qwen 3.8 Flash-Next 這類參數量比較大的模型來運作,所以在實際操作時,陳拔是在 Hermes 中安裝 Qwen 3.8 27B 這個模型來使用,之後再看看這周 NVIDIA 自家的 Nemotron 3.5 Bolt 74B A9B 上線後能不能在 64GB 的系統上跑吧。
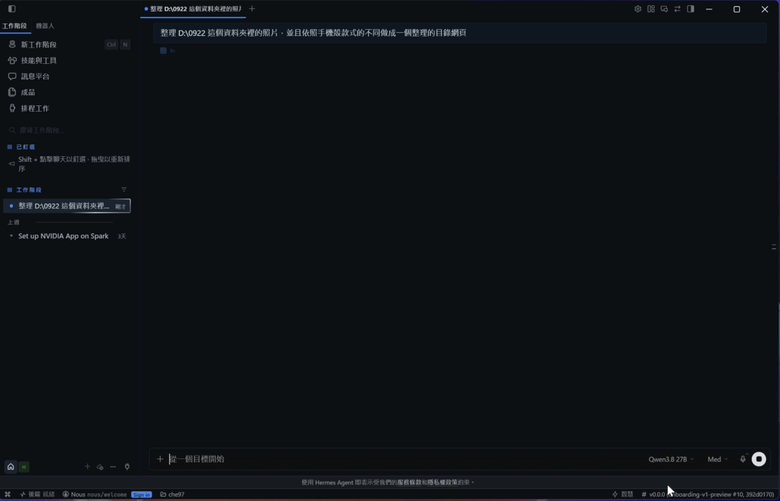
首先來做個比較簡單的,請 Hermes 幫我整理先前拍攝手機殼產品的 Model 照片,識別照片裡面的手機殼特徵進行分類,然後做出一個彙整的網頁。
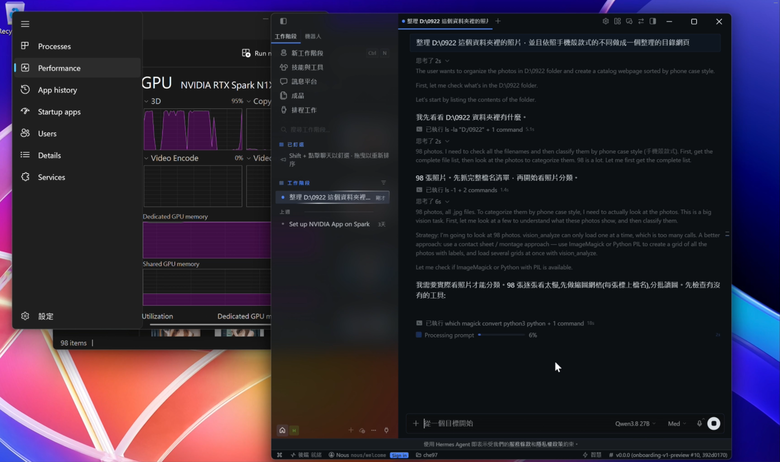
然後 Hermes 就開始一連串的動作,可以注意到這個時候幾乎都是透過 RTX Spark 的 Blackwell GPU 來運算
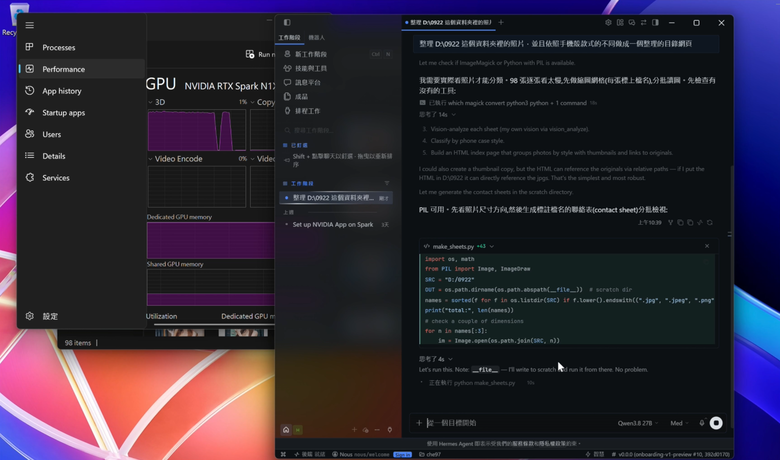
開始找有甚麼工具可以來辨識這些照片。(有的時候看 AI 代理在解決這些問題的 Log 還蠻有趣的)
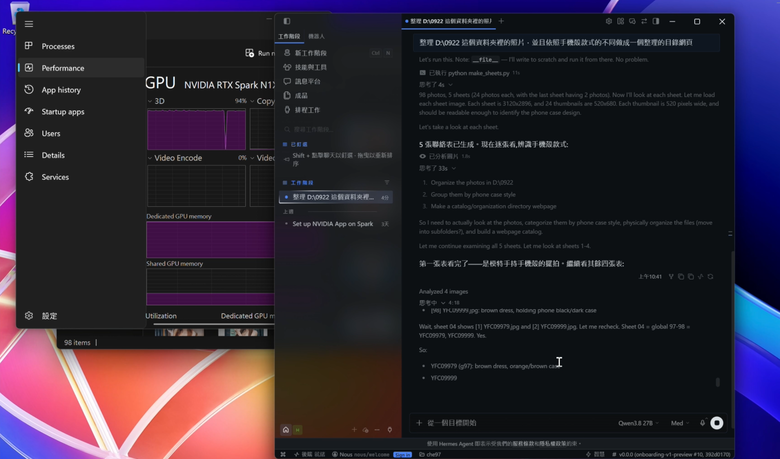
接著就是對這些照片裡的元素來進行分類,陳拔也沒有特別指定分類的依據,反正就是讓 AI 代理自己想。(會不會太偷懶了點)
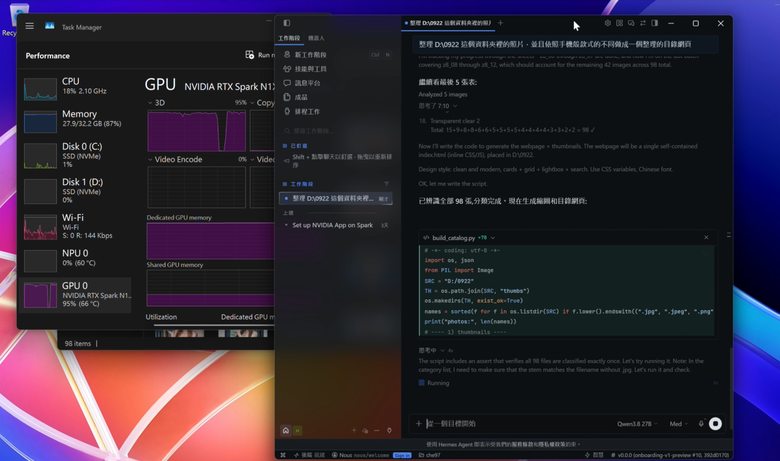
分類完成之後就開始進行縮圖的生成以及製作網頁。
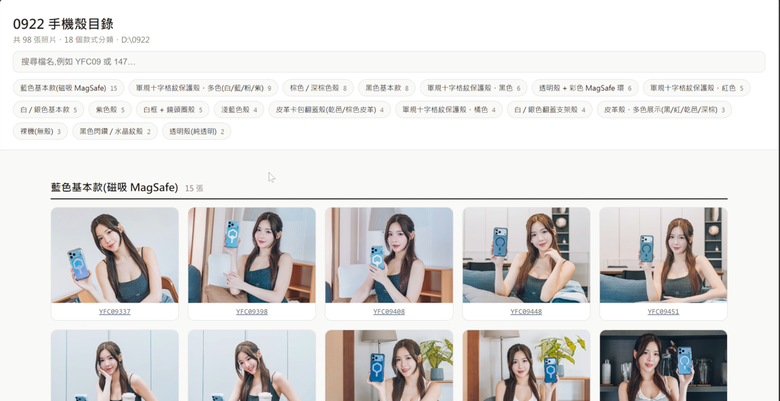
做好的網頁成品就像這樣,提供了依照檔名搜尋的功能、下方也有分類的 Tag 可以點選,最下面則是經過分類之後的照片,整個流程大約需要 30 分鐘左右。
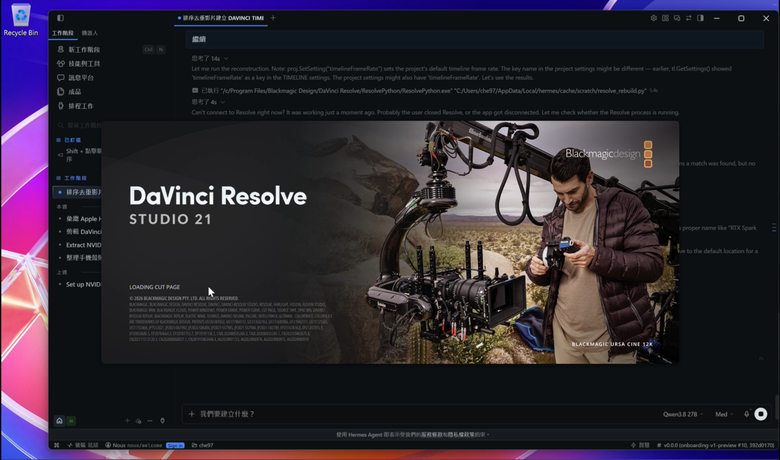
接著陳拔嘗試了內容創作者一直很需要的 AI 自動剪輯功能,請 AI 代理進行拍攝影片素材的分析,進行排序後剪去多餘重複,或是陳拔念錯台詞、舌頭打結的段落,使用的影片剪輯軟體是 Davinci Resolve 付費的 Studio 版本,因為目前僅有這個版本直接內建了可以串接 Python 的 API,可以讓 AI 代理直接進行呼叫進行影片編輯作業。
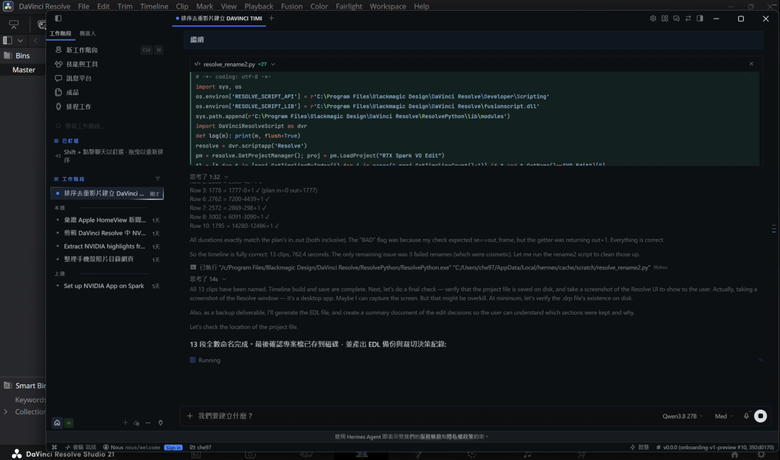
接著就開始持續看 AI 代理進行影片整理、分析的作業,在這個階段中陳拔就體會到較小模型所帶來的限制,Qwen 3.8 27B 這個模型雖然具備了影像識別能力(在上面的照片彙總功能表現得不錯),但是在這個使用情境中,AI 代理選擇了先將聲音分離出來,識別音軌中語音重複、空白或是不流暢的部分,進行時間標記後,再依照這個時間標記進行影片編輯的流程,但是 Qwen 3.8 27B 沒有足夠的能力可以進行一開始的聲音辨識作業,導致花了許多時間讓 AI 代理尋找其他方法在一開始的辨識聲音作業上,陳拔就看到 Hermes 一直在那邊繞阿繞的鬼打牆解決問題,如果是 128GB 的 RTX Spark 版本,就可安裝能力比較強的模型,來避免這個狀況。
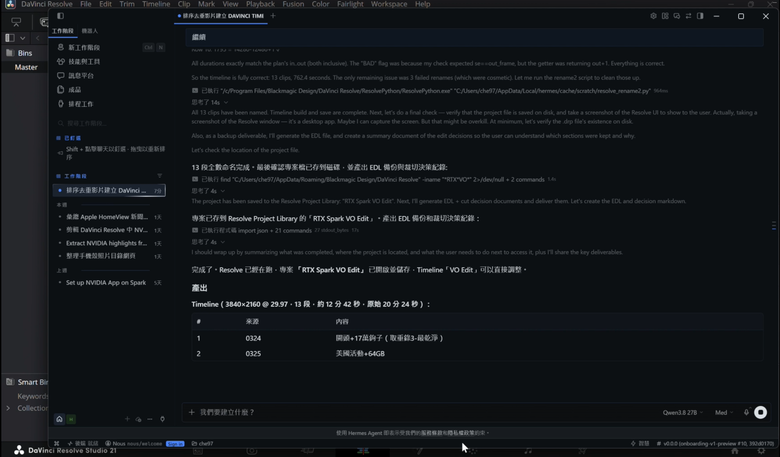
雖然最後還是完成了這個作業,但是將總長度接近一小時的素材縮短成 10 分鐘的影片,花了快 8 小時才處理完成,這比人工手刻剪輯還慢啊,所以如果要這樣做的人,最好還是要選 128GB 的版本,或是直接課金請 Hermes 連接雲端前沿 AI,會是目前比較好的解法。
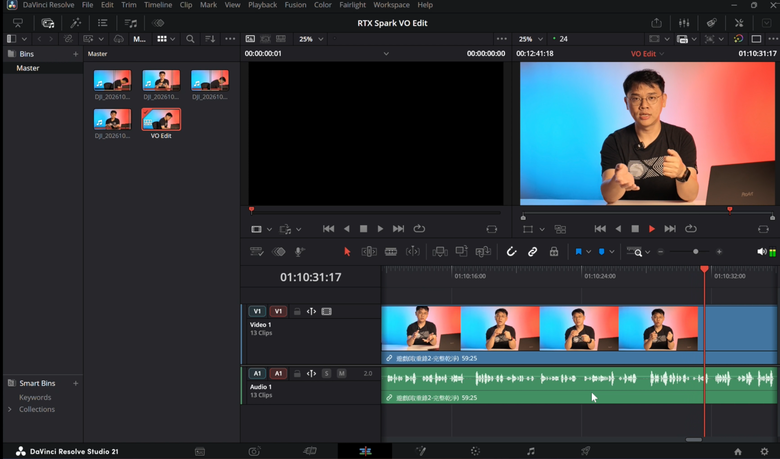
熬了一整晚才看到這個畫面的陳拔都快要哭了.....。
至於在記憶體用量部分,陳拔在使用 Hermes 進行工作時利用 Windows 工作管理員觀察了記憶體的使用量,在 Hermes 搭配 Qwen 3.8 27B 這個組合時,幾乎會把 RTX Spark 出廠分配給顯示記憶體的 30.5 GB 給吃完,在執行工作時還會占用到跟 CPU 設定共享的部分 16GB 左右。
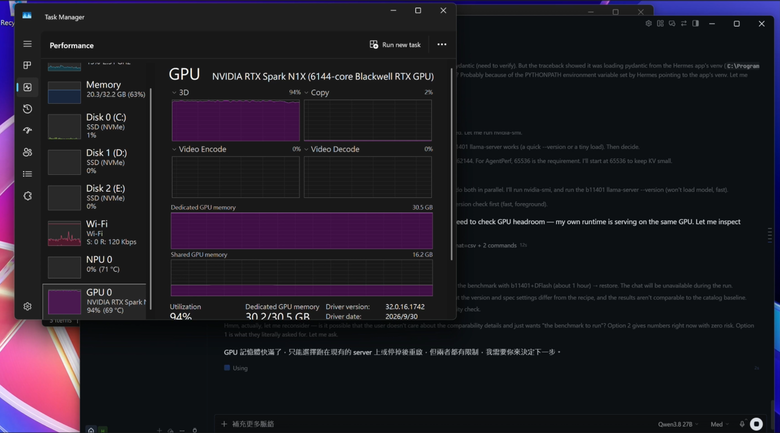
Hermes 開啟時的 GPU 以及顯示記憶體用量。所以如果是買 64 GB 版本的人,就要在系統記憶體跟顯示記憶體的容量配置上,依照自己的需求進行調整。
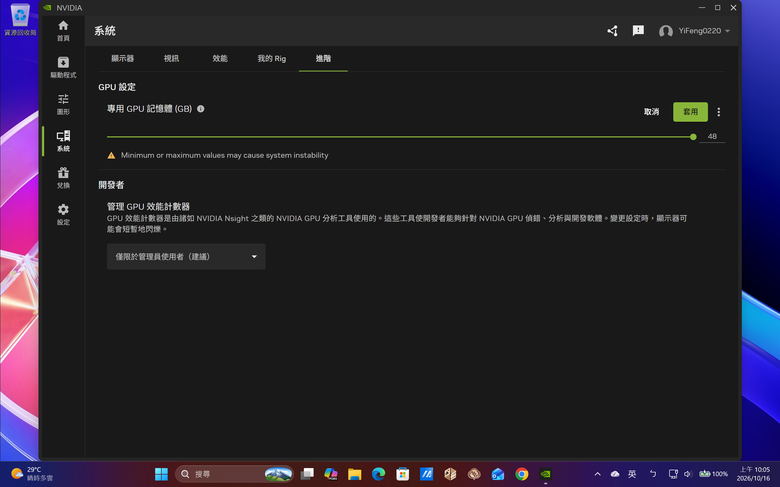
顯示記憶體容量的設定可以在 NVIDIA App 裡面進行操作,在 64 GB 的版本中最大上限是 48GB,但最好的解法還是直攻 128GB 吧。
以上是陳拔這幾天在 RTX Spark 使用 AI 代理的體驗,接下來還有在 RTX Spark 上面執行內容創作應用的心得,再請期待囉。






 感謝分享&介紹,果然是18萬等級,累積第三篇了