常遇到 文字 長度問題,
只可以 短 不可以 長,
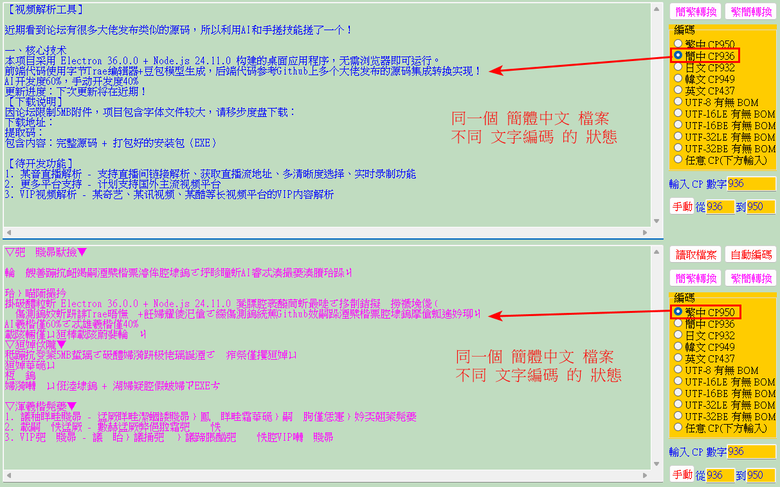
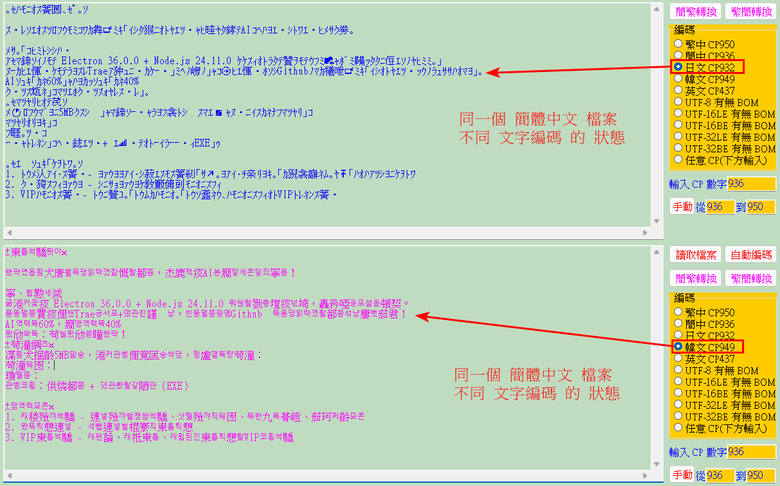
懂 文字 的 各種編碼 就 賊重要.

樣本 .txt
供參考 文字 長度問題.
[點擊下載]

ren1244 wrote:
怕路過的網友誤會,還是補充一下好了
ANSI 一開始算是微軟的誤用
它真實的編碼隨 windows 語系的設定而有不同
CP950(來自 BIG5)、CP936(來自 GBK) 等才是實際的編碼
(可以把 ANSI 當作這些的總稱)
另外 unicode 只是定義了文字與數字(code point,又稱碼位)的對應關係
至於儲存為文字檔的位元組序列是由 UTF-8、UTF-16、UTF-32 等來決定
例如中文「好」這個字,unicode 是 597d(十六進位)
用 UTF-8 會被儲存為:e5 a5 bd,共 3 個位元組
用 UTF-16 會被儲存為:59 7d(BE)或 7d 59(LE),共 2 個位元組
用 UTF-32 會被儲存為:00 00 59 7d(BE)或 7d 59 00 00(LE),共 4 個位元組
雖然儲存在磁碟的位元組序列不同,但他們都對應到同一個數字:597d(十六進位),這個數字在 unicode 中代表「好」
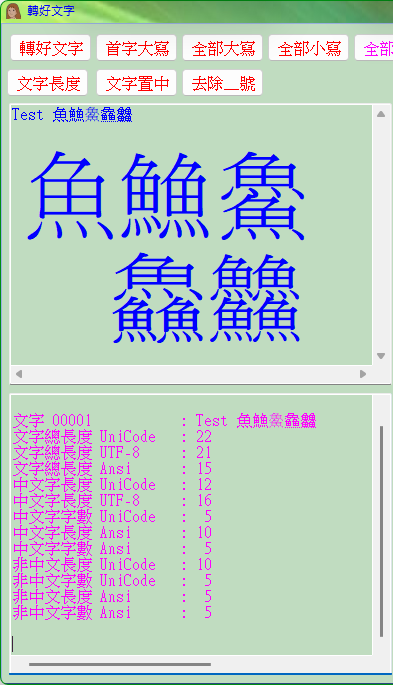
至於樓主圖片中的 UniCode 長度,實際上應該是 UTF-16 編碼後的位元組序列長度
原本 4 個英文 + 1 個空格 + 5 個中文,應該是 (4+1+5) x 2 = 20 byte
但因為有一個中文的 unicode 超過 0xffff,所以 UTF-16 會用代理對的方式處理
也就是說必須要 4 個 byte 才能表達這個字
因此才會是 22 byte
至於後面的 ANSI 長度實際用什麼編碼就不知了
只知道那個字串不論是 CP950 還是 CP936 都無法成功編碼


<meta charset="UTF-8">。Content-Type: text/html; charset=utf-8。